Un exemple
Partons d’une phrase inachevée
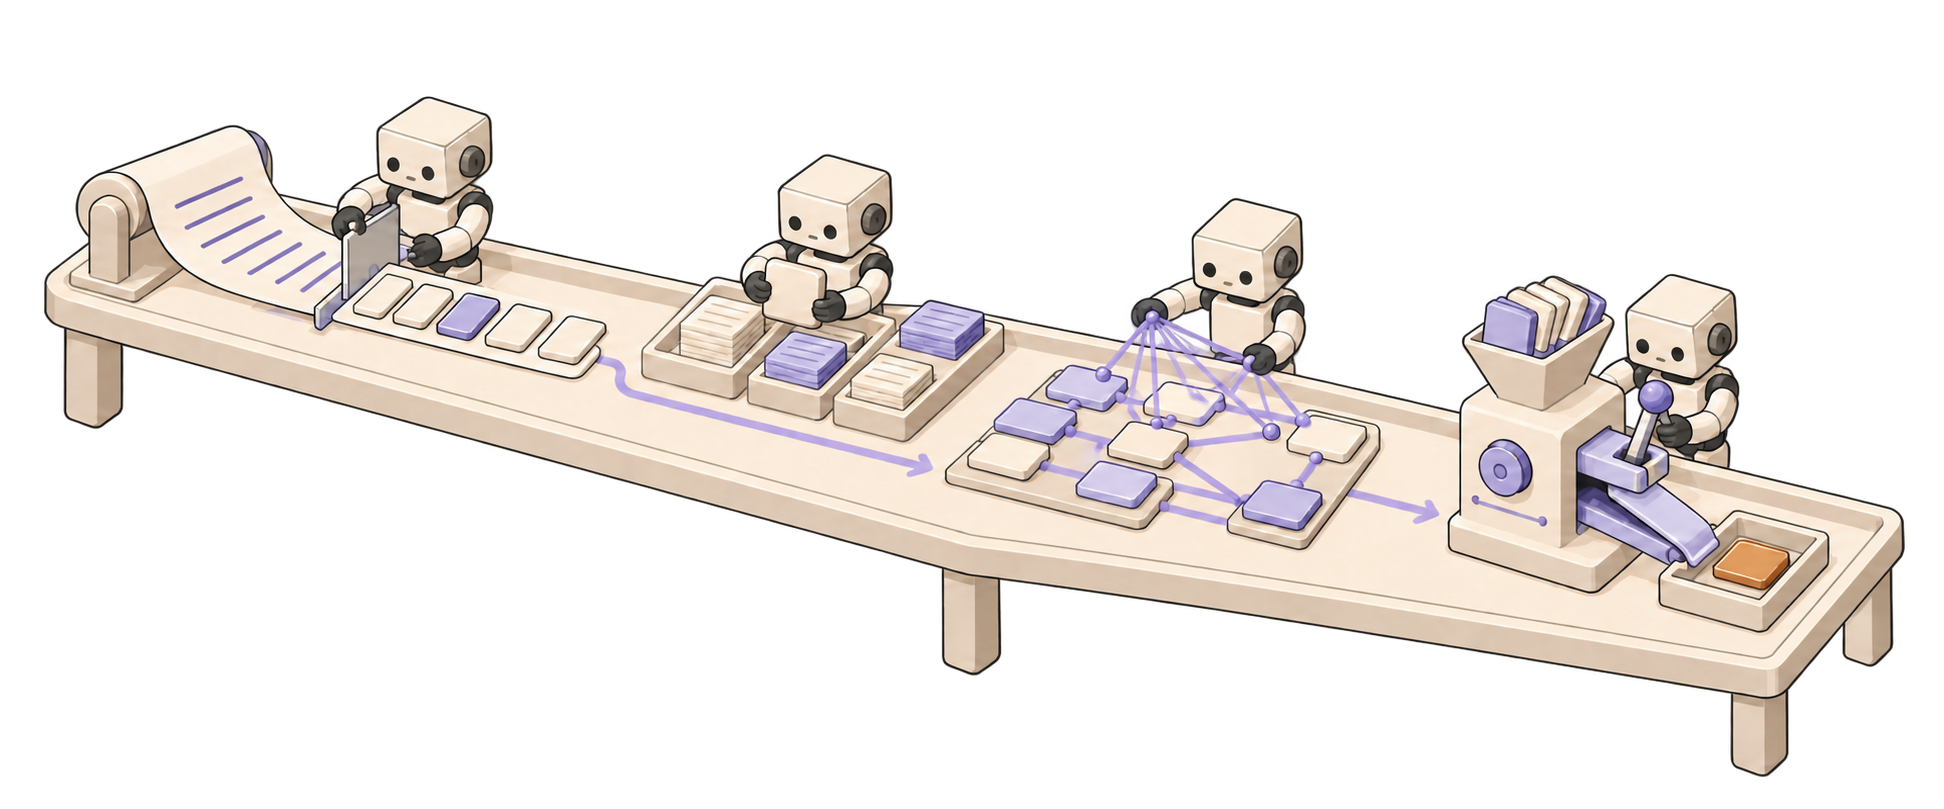
Le schéma évolue avec la lecture. Chaque étape peut aussi être sélectionnée.
Il reçoit « Le chat dort sur le… » et compare plusieurs façons de compléter la phrase. Dans cet exemple, « canapé » arrive devant « lit » et « tapis ».
Les pourcentages servent uniquement à montrer le calcul. Ils ne disent pas si la phrase est vraie.
Le modèle ajoute « canapé » au texte. Il relit alors la phrase complétée et calcule ce qui pourrait suivre.
La réponse se construit ainsi, un choix après l’autre. Elle n’est pas écrite d’un seul coup.
En réalité, le modèle ne lit pas toujours des mots entiers. Le texte est coupé par un programme appelé Le programme qui découpe un texte en morceaux que le modèle sait manipuler.. Chaque morceau porte le nom de Un morceau de texte : parfois un mot entier, parfois une partie de mot ou un signe.. Il peut s’agir d’un mot, d’un bout de mot ou d’un signe.
Le programme de découpage associe un numéro à chaque morceau. Le modèle utilise ensuite cette suite de numéros pour commencer ses calculs. Un numéro reste une étiquette : 7 345 n’est pas plus important que 142.
Aucun dictionnaire ne contient tous les noms, les fautes et les mots qui seront inventés demain. Le modèle utilise donc une liste fixe de morceaux. Lorsqu’un mot n’existe pas en un seul morceau, le programme le découpe en plusieurs morceaux de cette liste.
Le chat dort sur le…
Ce mécanisme peut produire un texte très cohérent. Il n’implique pourtant ni conscience, ni intention personnelle, ni expérience vécue : une phrase assurée n’est pas une conviction.
Derrière chaque numéro, une liste de nombres
Le numéro permet de retrouver cette liste. C’est à partir de ces nombres, et non du mot écrit, que le modèle effectue ses calculs.
Prenons le morceau « avocat ». Son numéro renvoie à une ligne dans une grande table. Cette ligne contient beaucoup de nombres, positifs ou négatifs. L’ensemble forme un Une longue liste de nombres utilisée par le modèle pour ses calculs.. Il n’est pas nécessaire de savoir lire chaque valeur séparément : c’est leur combinaison qui sert de point de départ au calcul.
[0,18 · −0,42 · 0,07 · …]Ce point de départ évolue avec les morceaux placés autour. « Avocat » ne joue pas le même rôle dans « l’avocat plaide au tribunal » et dans « elle écrase un avocat pour le guacamole ».
Le sens dépend de ce qui l’entoure
Dans une phrase, un même morceau change de rôle selon les mots placés autour de lui. Le modèle doit retrouver ces liens.
Pour mettre à jour chaque ligne de nombres, le système donne plus ou moins d’importance aux morceaux qu’il peut encore voir. Cet ensemble de texte visible s’appelle le Les tokens visibles pendant le calcul : consignes, messages, documents fournis et tokens déjà générés, dans une limite maximale.. Le calcul qui relie ces morceaux s’appelle l’Le calcul qui détermine quels autres morceaux doivent compter davantage pour traiter celui-ci..
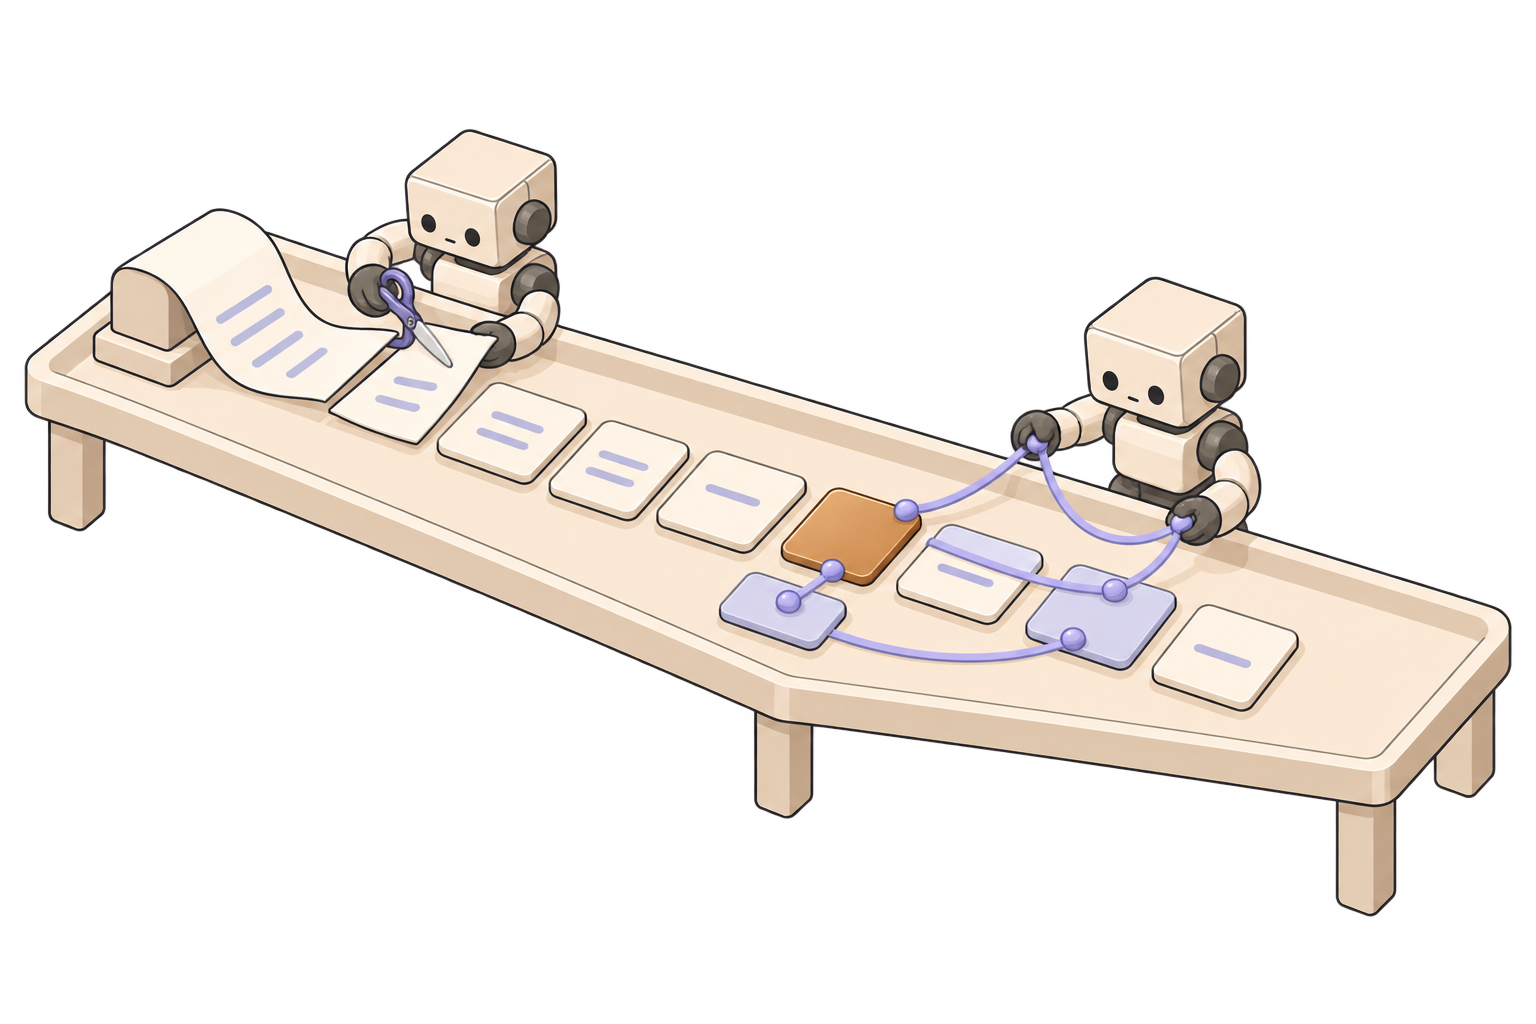
Dans « Le trophée ne rentre pas dans la valise parce qu’il est trop grand », l’information liée à « trophée » doit compter davantage pour interpréter « il ». Le modèle calcule plusieurs jeux de liens en parallèle, puis les combine.
Ce mécanisme repère des relations apprises pendant l’entraînement. Il peut être très efficace sans pour autant prouver que le modèle comprend la scène comme une personne.
Le modèle calcule le prochain token
À chaque étape, le modèle compare toutes les pièces disponibles et leur attribue une chance d’être la suivante.
Le modèle produit d’abord un score pour chaque token de son La liste fixe des morceaux de texte disponibles pour ce modèle.. Ces scores deviennent une distribution de La part attribuée à un prochain token possible dans ce contexte. Elle n’indique pas que l’énoncé est vrai. dont le total vaut 100 %. Un token à 62 % n’est pas « vrai à 62 % » : il est simplement le candidat le plus compatible avec la suite, compte tenu du contexte.
Le modèle…
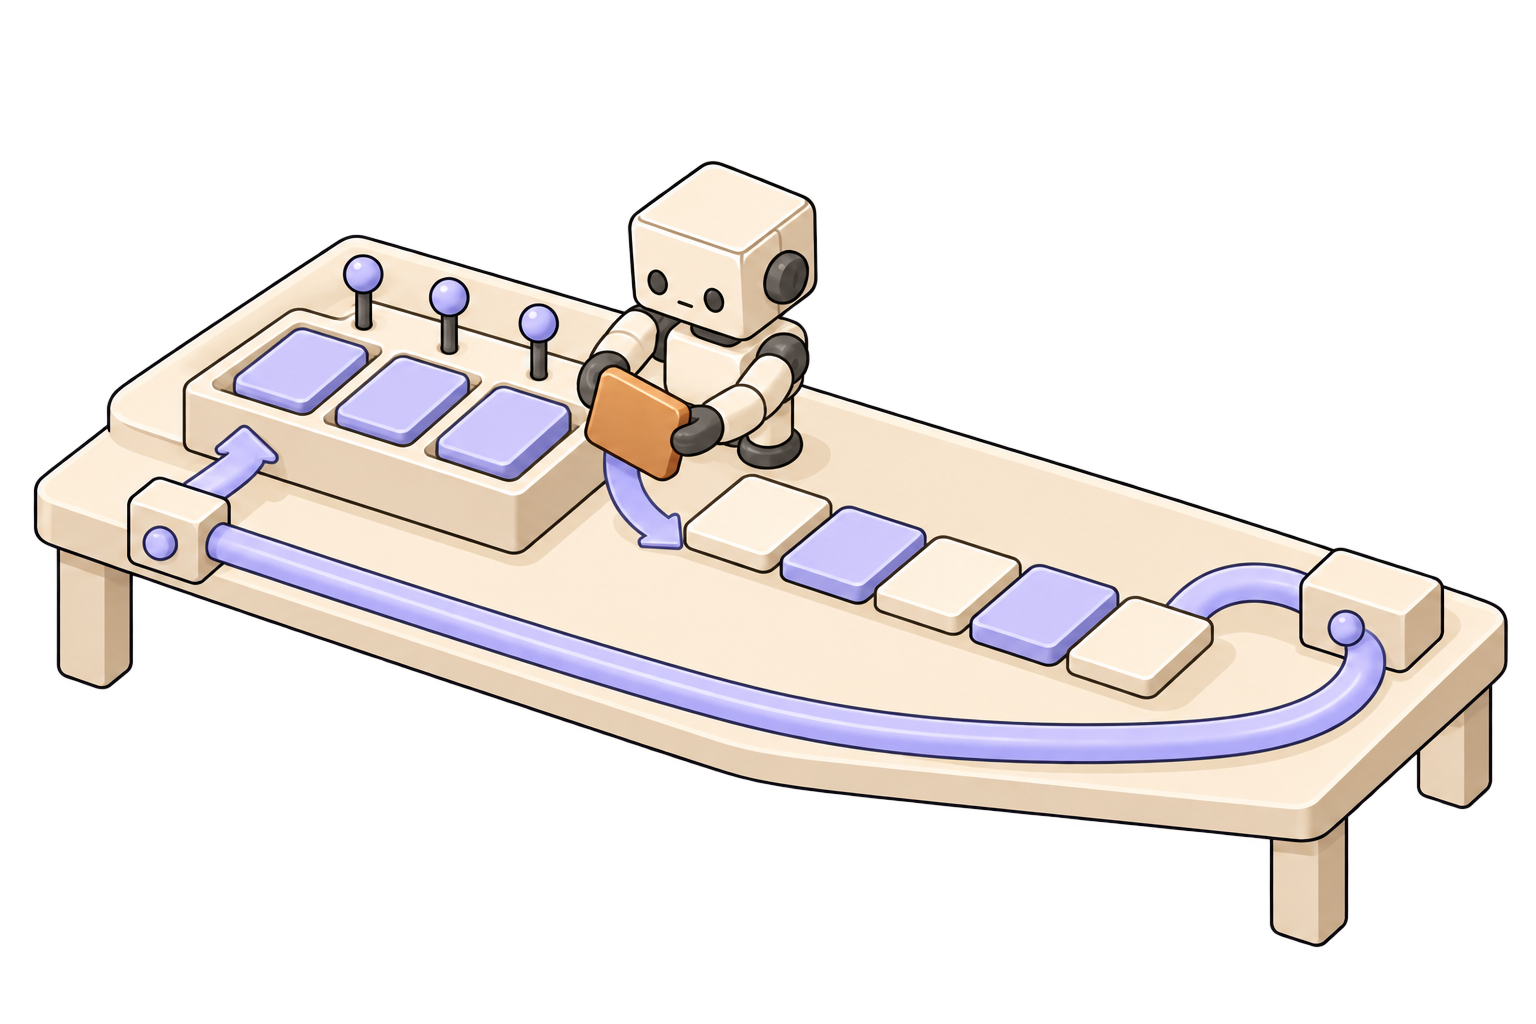
Le système choisit ensuite le candidat dominant ou en tire un parmi plusieurs, selon ses réglages. Le token retenu rejoint le contexte, puis tout le calcul recommence. Une différence au début peut donc modifier le reste de la réponse.
Des capacités, sans intention propre
Un LLM peut accomplir des tâches complexes. Son fonctionnement ne montre ni intention personnelle ni expérience vécue, et rien ne permet d’établir qu’il est conscient.
Il peut résumer, traduire, écrire du code ou résoudre certains problèmes. On peut appeler cela des capacités intelligentes. Mais son mécanisme ne lui donne ni besoin ni intention propre : il ne cherche pas spontanément à aider ou à dire vrai. Il exécute un calcul à partir du texte reçu et des paramètres appris pendant l’entraînement.
Le mot « comprendre » peut désigner deux choses. Le modèle sait parfois utiliser une relation apprise et l’appliquer à un cas nouveau. En revanche, rien dans ce mécanisme n’établit qu’il éprouve le sens d’une phrase ou comprend le monde comme une personne.
Plausible ne veut pas dire vrai
Pendant son entraînement, le modèle apprend à prévoir le token suivant ; ce calcul ne vérifie pas qu’un énoncé est vrai.
On parle d’hallucination lorsqu’une réponse plausible invente ou déforme un fait. Pour réduire ce risque, on peut brancher le modèle sur des sources vérifiables, conserver la trace des sources utilisées et faire valider les décisions importantes par une personne. Les sources, les outils et les contrôles ne viennent pas du LLM : ils doivent être ajoutés par le système qui l’entoure.